

Me preguntan a menudo cuál es el mejor OCR, y la respuesta incómoda es que no existe. El que borda una factura escaneada se pierde con una nota manuscrita, y el que domina las tablas tropieza con un ticket arrugado. Lo que sí existe es un método para averiguarlo con TUS documentos. Nosotros lo hemos hecho: siete rondas de shoot-out sobre un corpus real de facturas escaneadas, con verdad de referencia validada a mano. Estos son los números.
Ingenieria
Soft2Help (Internal)
Python, RapidOCR / PP-OCR, PaddleOCR, MinerU, Chandra, Modelos de visión (VLM), CUDA / GPU propia, Docker
«¿Qué OCR me recomiendas?» es una pregunta trampa. Llevo años digitalizando archivos (facturas, contratos, expedientes, papeles de hace décadas) y si algo he aprendido es que ningún motor gana en todo. Los rankings de internet comparan motores sobre datasets académicos que no se parecen en nada al cajón de papeles real de una empresa: escaneos torcidos, sellos encima del texto, fotocopias de fotocopias, letra de médico.
La única respuesta honesta es: depende de tus documentos. Y eso no se opina; se mide. Así que lo medimos.
El corpus: 56 facturas escaneadas reales (102 páginas) de cinco empresas distintas, con los seis campos que importan en contabilidad (NIF, número de factura, fecha, base imponible, IVA y total) validados a mano por humanos como verdad de referencia. Nada de datasets académicos: papel real, escaneado como se escanea en una oficina.
Encima, un harness reproducible: pasa cada motor candidato por todo el corpus, normaliza formatos (fechas, decimales) y puntúa campo a campo. Montarlo costó una tarde con ayuda de la IA; re-evaluar un motor nuevo cuesta minutos. Resultado: siete rondas de shoot-out en tres semanas, cada una respondiendo una pregunta concreta. El servicio final lleva además su propia batería de tests automatizados (30+ tests con salidas reales de los motores como fixtures), para que recalibrar algo no rompa lo demás sin enterarnos.
Primera pregunta: de los motores que corren en CPU, sin GPU y sin pagar por página, ¿cuál recupera más datos? Métrica: el valor correcto aparece en el texto extraído.
| Motor | % campos recuperados | Velocidad (por página) |
|---|---|---|
| RapidOCR (PP-OCR sobre ONNX) | 86,3% | ~4 s en CPU |
| PaddleOCR PP-OCRv5 server | 84,5% | ~42 s |
| MinerU (layout + tablas + markdown) | 73,5% | ~3-30 s |
Segunda pregunta, con métrica más exigente: no «¿está el dato en el texto?» sino «¿me devuelve el campo extraído, estructurado y exacto?». Aquí entran los modelos grandes de visión leyendo el PDF directamente:
| Campo | Modelo rápido | Modelo avanzado |
|---|---|---|
| NIF del emisor | 38% | 82% |
| Nº de factura | 91% | 100% |
| Fecha | 89% | 96% |
| Total | 82% | 86% |
| Global | 74% | 86% |
| Facturas perfectas (6/6 campos) | 15/56 | 35/56 |
Durante las semanas siguientes pasamos por el mismo corpus cada modelo especialista en OCR que la prensa técnica coronaba como el nuevo campeón. Todos llegaban con benchmarks públicos espectaculares. Contra nuestras facturas:
| Modelo (afinado para OCR) | Benchmark público | En nuestro corpus | Veredicto |
|---|---|---|---|
| GLM-OCR 0.9B | 94,6 (casi SOTA) | 84% presencia, 59% estructurado | Descartado: peor que el clásico y necesita GPU |
| Unlimited-OCR 3B | 93,2 (SOTA) | 83,3%, y 16× más lento | Descartado |
| Gemma 4 12B | ~95 en DocVQA | 31%, e inventa dígitos plausibles | Descartado con alarma |
| PaddleOCR-VL 0.9B | 94,5 (sobre GPT-4o) | 83,6%, empate técnico con el clásico | Descartado: mismo resultado a 14× el coste |
Otra constante: el techo de ~86% en presencia de campos lo marcaron los propios escaneados, no los motores. A partir de cierta calidad de papel, cambiar de motor no compra nada.
Todo lo anterior es documento impreso. Con manuscrito el cuadro cambia por completo, y aquí el corpus de pruebas es especialmente mío: mis propias libretas de hace años, con ideas de proyectos que nunca digitalicé porque ningún OCR podía con ellas.
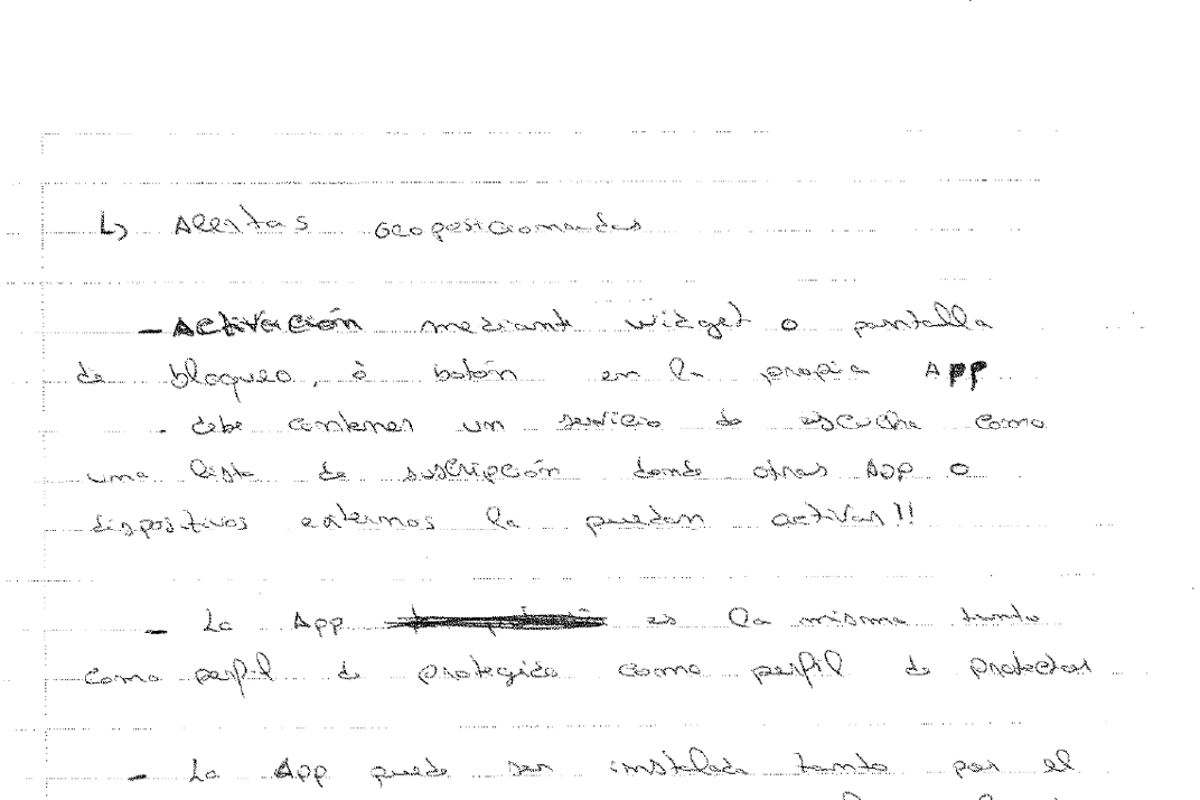
Los OCR clásicos producen con esto directamente basura: texto corrupto, inutilizable (la literatura independiente mide <3% de palabras exactas en manuscrito difícil). Los modelos grandes de visión, en cambio, sacan texto casi perfecto de las mismas páginas, con layout respetado e incluso las tachaduras marcadas.
Y aquí toca dar un nombre: de todo lo que he probado, Chandra es de lejos el que mejores resultados produce en manuscrito. Nada de lo que ha pasado por el banco de pruebas se le acerca: transcribe mis libretas casi perfectas donde el resto ni empieza. La letra pequeña es que cobra en GPU y en tiempo por página: es un modelo pesado, que quiere una gráfica seria y avanza a ritmo de segundos por página, no de milisegundos. Mi lectura práctica: si es para un servicio propio, con tu volumen y tu paciencia, adelante: GPU en casa y a correr. Pero si vas corto de VRAM, o quieres dar servicio a terceros con garantías de latencia y volumen, probablemente lo sensato sea subalquilar la solución: la versión alojada por API o GPU por horas, pagando céntimos por página en vez de mantener el hierro encendido. Es la misma lógica de todo el artículo: el motor caro, solo para los documentos que lo necesitan, y solo en la modalidad que te salga a cuenta.
Con matiz importante: eso vale para notas y texto corrido. Los formularios manuscritos (casillas, campos, letra apretada) siguen siendo el punto débil universal: ahí ningún modelo actual pasa del aprobado raspado, y la revisión humana no es opcional.
Este experimento viene de antes del shoot-out, y le tengo cariño porque conecta con la otra mitad de mi trabajo: la gestión documental. El motor clásico de aquellas pruebas era el de Therefore, el gestor documental de Canon que llevo más de una década implantando y que bajo el capó utilizaba IRIS como motor de OCR. Y un apunte justo: su Capture Client era un buen cliente para hacer automatizaciones de captura (carpetas vigiladas, perfiles de escaneo, clasificación al vuelo); el eslabón débil no era el flujo, era lo que el OCR de entonces podía leer.
La prueba: cogimos una factura real y generamos 29 variantes degradadas (desenfoque, brillo, ruido, resolución, inclinación, y combinados tipo «fotocopia vieja», «fax», «foto de móvil»). Umbrales medidos con ese OCR clásico:
La conclusión transversal de todas las rondas: ni el mejor OCR ni el mejor modelo de visión bastan solos. Lo que sí funciona, medido:
1. Dos lecturas independientes del mismo documento, con motores de familias distintas, y comparar campo a campo.
2. Validación aritmética encima (¿base + IVA ≈ total?): esa regla sola cazó 22 de 22 casos en que ambas lecturas coincidían en un valor equivocado. Todos eran discrepancias contables (retenciones, suplidos), no errores de lectura.
3. El resultado final: en documentos que pasan la validación, el acuerdo entre las dos lecturas tuvo 100% de precisión medida (197/197 campos). Eso permite auto-aprobar ~89% de los campos con cero errores observados, y mandar a revisión humana solo el ~11% restante más los documentos marcados.
Coste de todo el cruce: unos céntimos por documento escaneado. Y solo los escaneados, que son ~10% del volumen real.
Con los datos encima de la mesa, el sistema no elige «un OCR»: elige una cadena, con lo barato primero y lo pesado al final:
Documento
    -> ¿tiene capa de texto? (~90% de docs reales)
         sí -> extracción directa, milisegundos, gratis
    -> clasificador ligero (impreso / manuscrito / degradado)
    -> impreso  -> motor clásico rápido en CPU
    -> ¿salida sospechosa? (detector de texto-basura, sin diccionario)
         -> siguiente motor de la cadena
    -> tablas y estructura -> motor de layout, bajo demanda
    -> manuscrito o degradado -> modelo de visión grande
    -> campos críticos -> segunda lectura independiente + validación
         acuerdo -> auto-aprobado | desacuerdo -> revisión humana
La mayoría de los documentos los resuelve la vía barata en milisegundos; solo los difíciles escalan hasta la artillería. Y cuando los documentos no pueden salir de la empresa, esa artillería corre en GPU propia, en casa.
No existe: depende de tus documentos, y eso no se opina, se mide con un corpus propio. En nuestro shoot-out sobre 56 facturas escaneadas reales, el motor más ligero (RapidOCR, unos 50 MB de modelos) ganó a los grandes en precisión y en velocidad: 86,3% de campos recuperados a unos 4 segundos por página en CPU.
No transfieren a documentos reales: pasamos siete modelos coronados por la prensa técnica por el mismo corpus y los siete quedaron por debajo de lo prometido. El caso más peligroso puntuaba ~95 en benchmarks públicos y sacó un 31% con nuestras facturas, inventando además dígitos plausibles: NIFs cambiados, fechas alteradas, importes cercanos pero falsos.
Con dos lecturas independientes del mismo documento usando motores de familias distintas, comparadas campo a campo, y una validación aritmética encima (¿base más IVA es igual al total?). Medido sobre nuestro corpus: 100% de precisión en los campos donde ambas lecturas coinciden y la validación pasa, lo que permite auto-aprobar cerca del 89% y mandar a revisión humana solo el resto.
Los OCR clásicos producen texto corrupto con manuscrito difícil; los modelos grandes de visión lo transcriben casi perfecto, con layout y tachaduras incluidos. De todo lo probado, Chandra es de lejos el mejor en manuscrito, a cambio de pedir una GPU seria y segundos por página. Los formularios manuscritos con casillas siguen siendo el punto débil universal: ahí la revisión humana no es opcional.