

Uno de los grandes portales de anuncios de Europa necesitaba publicar automáticamente las ofertas de empleo que sus clientes ya tenían en sus propias webs. La solución: un pipeline de scraping autorizado, montado con Rails sobre AWS Lambda, que lleva años funcionando estable, recogiendo, transformando y entregando ofertas sin que nadie lo vigile.
Casos
Rails 7, AWS Lambda, S3, CloudWatch, Docker, ECR, GitHub Actions, Selenium, Ruby
Las empresas publican sus ofertas de empleo en sus propias webs, cada una con su formato. El portal quería esas ofertas dentro, actualizadas, sin pedir a cada empresa que aprendiera a mandar ficheros. El puente: ir a la web de cada cliente, recoger las ofertas y entregarlas en el formato estándar del portal.
Este scraping se hace con permiso y por encargo: las empresas quieren aparecer en el portal: el crawler trabaja para ellas, no contra ellas. No es un matiz menor: scrapear con autorización te deja identificarte, pactar frecuencias razonables y hablar con la otra parte cuando algo cambia. El scraping "de guerrilla" es otro deporte, y no es este.
Rails y Lambda no son pareja de manual: Rails quiere un servidor encendido; Lambda cobra por segundo de ejecución. Pero aquí el trabajo es a ráfagas: cada cliente se rastrea unas veces al día y el resto del tiempo no hay nada que hacer. Pagar un servidor 24/7 para eso es tirar dinero.
La solución: Rails 7 en modo API, contenedizado, corriendo como función Lambda. Despliegue por imagen Docker (vía ECR y GitHub Actions), y cero servidores que parchear, monitorizar o reiniciar. Años después, sigue siendo la decisión más rentable del proyecto.
Sin servidor no hay crontab. El planificador es CloudWatch: una regla por cliente con su frecuencia, que dispara la Lambda con el cliente como parámetro. Y las reglas no se tocan a mano: se declaran en la configuración de cada cliente y una tarea las sincroniza:
bin/rails feeds:rules:sync # las reglas de CloudWatch reflejan la config, siempre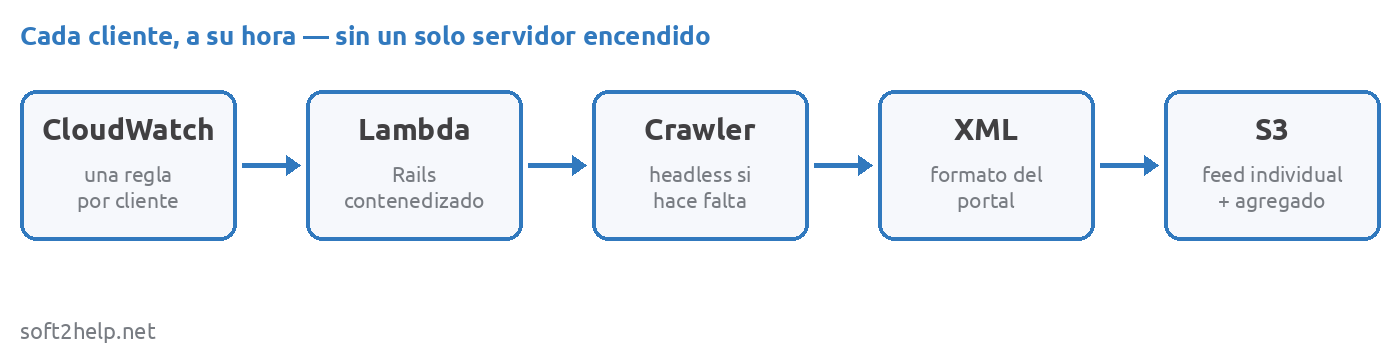
Muchas webs de ofertas pintan el contenido con JavaScript: sin ejecutar un navegador no hay datos. Eso significa Chrome headless con Selenium dentro de una Lambda: memoria justa, arranques en frío y un navegador entero viviendo en una función pensada para durar segundos. Ajustar contenedor, tiempos y reintentos para que eso sea estable fue de las partes más finas del proyecto.
Varias webs exigen autenticación: tokens que expiran, sesiones que se invalidan, cabeceras que cambian. El crawler renueva las credenciales solo y reintenta con cabeza, porque un pipeline sin nadie mirando no puede quedarse parado esperando a que un humano refresque un token.
Recoger es la mitad; la otra mitad es normalizar: cada web llama a las cosas a su manera, y el portal exige categorías, tipos de contrato y referencias en su estándar. Cada cliente tiene su crawler heredando de una plantilla común: listar ofertas y extraer campos, y el resto (mapeo de categorías, XML, subida) viene de serie:
class Crawlers::ClientName::Crawler < Crawlers::Base
  def parse_offers(doc)
    # recorrer el listado de ofertas del cliente
  end

  # un método por campo: title, description, city, job_type, date...
  def title       = detail(".job-title")
  def city        = detail(".location")
end
Dar de alta un cliente nuevo es crear su crawler con esa plantilla y registrarlo: horas, no semanas.
El proyecto vive por duplicado: un entorno de staging propio (con sus Lambdas, sus reglas y sus buckets) y el de producción. Toda integración nueva se estrena en staging: el crawler recién escrito genera feeds reales contra el entorno de pruebas, se revisa el XML con calma, y solo cuando convence se promociona.
La mecánica es deliberadamente simple: dos remotes de git, cada uno con su CI/CD independiente. Un push al remote de staging despliega staging; un push al de producción despliega producción. Promocionar una versión es empujar al otro remote, sin ramas mágicas, sin botones especiales, y con la garantía de que lo que llega a producción es exactamente lo que se probó:
git push staging main      # se despliega el entorno de pruebas
# ... se valida el feed en staging ...
git push production main # lo mismo, ahora en producción¿Lo más difícil del proyecto? No fue Lambda ni el headless: fue aceptar que las webs ajenas cambian sin avisar. El sistema asume la rotura como estado normal: avisos cuando un crawler baja de ofertas de repente, campos con valores por defecto sensatos, y errores que señalan exactamente qué selector dejó de existir. Diseñar para el fallo es lo que le ha dado años de estabilidad.
El pipeline lleva años en producción entregando feeds a diario, con mantenimiento ocasional y coste serverless mínimo: se paga por minutos de trabajo real, no por servidores esperando. Las ofertas de cada cliente aparecen en el portal solas, actualizadas y en su formato. Y cuando llega un cliente nuevo, la plantilla hace que sea rutina.